AI Agent 决策模型:OpenAI Decisions API、Jev 与 LLM 路由应该怎么分工?
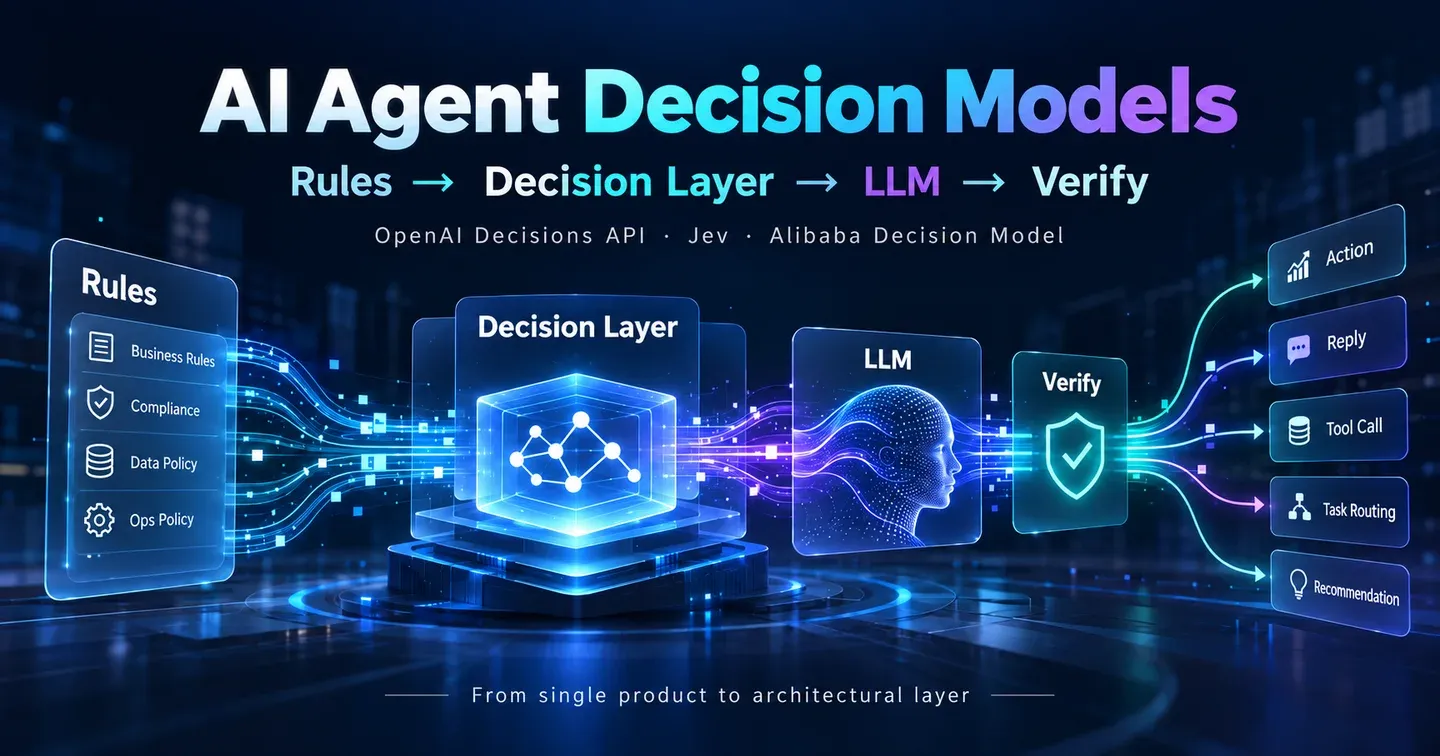
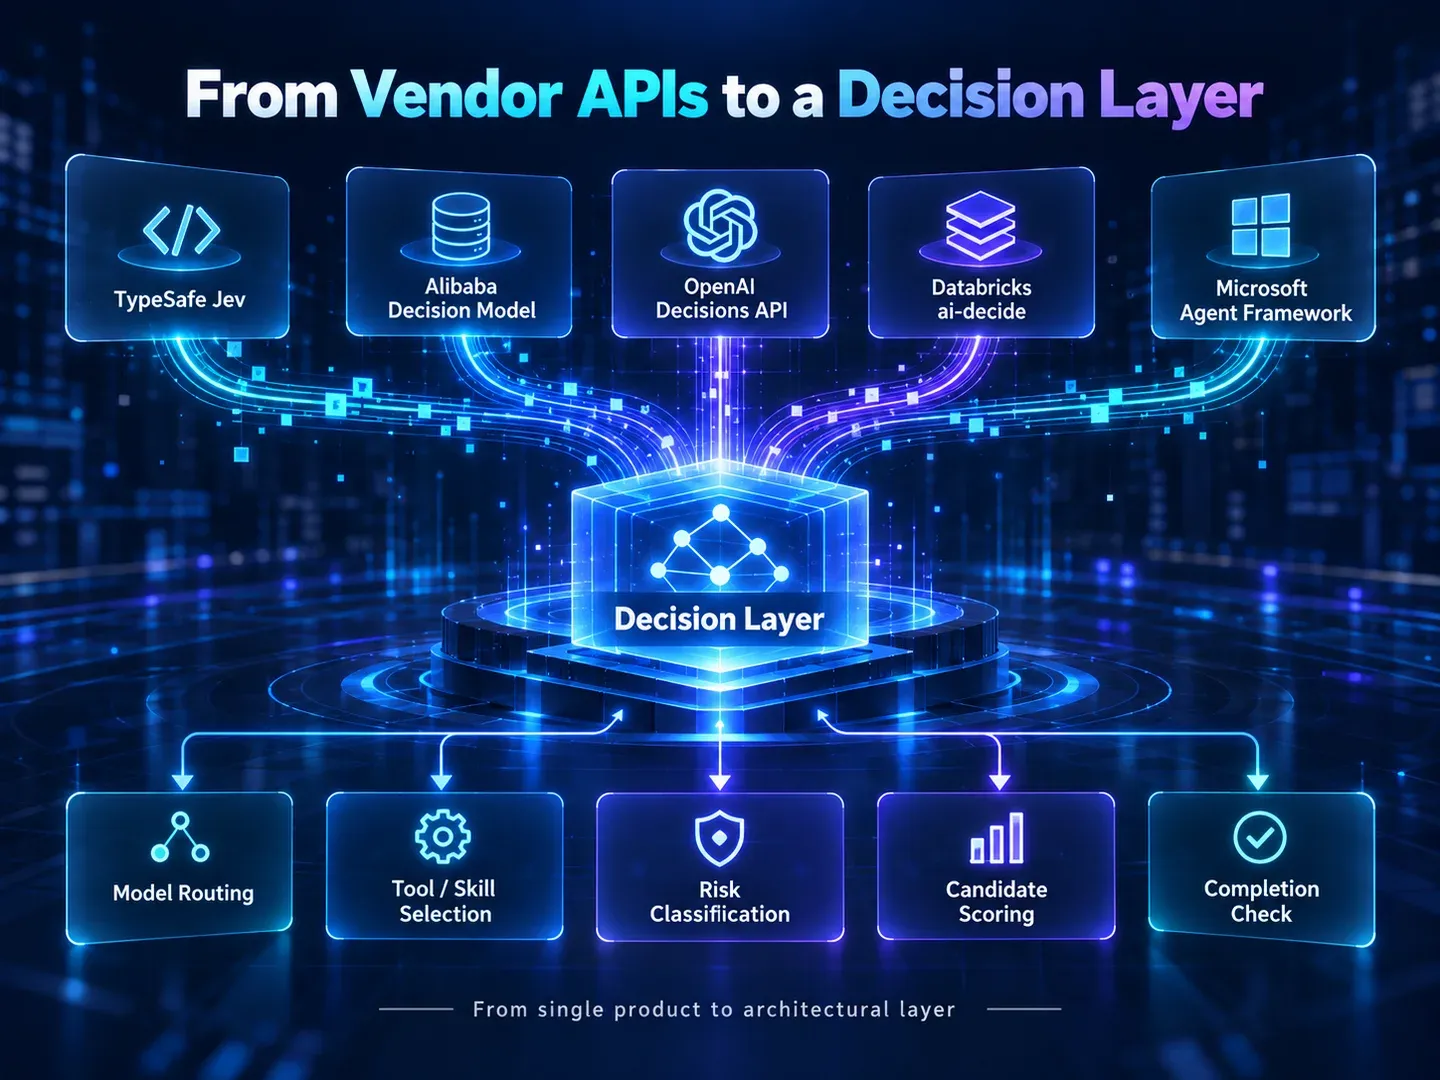
2026 年 9 月到 10 月,Jev、Alibaba Decision Model、OpenAI Decisions API、Databricks ai-decide 与 Microsoft Agent Framework 的提案开始指向同一个趋势:把路由、评分、Tool/Skill 筛选、完成判定等有限决策从生成式 LLM 中拆出来,形成独立 Decision Layer。本文给出厂商中立的生产架构、边界与评估方法。
Evidence 10 条资料来源
本文目录
直接答案:AI Agent 正在形成一层独立于“生成式大模型”的 Decision Layer。它不是为了写更短的回答,而是专门处理那些最终只需要有限选择、概率、等级或真假判断的步骤:模型路由、Tool/Skill 筛选、风险分级、候选评分、任务是否完成、是否升级到强模型或人工。2026 年 9 月到 10 月,Jev、Alibaba Decision Model、OpenAI Decisions API、Databricks ai-decide 和 Microsoft Agent Framework 的相关提案已经出现明显趋同。
这条趋势值得提前布局,是因为它解决的不是某个 API 的短期功能,而是 Agent 生产化里一直存在的结构性浪费:很多系统让一个昂贵、开放式的生成模型去回答“是/否”“选 A/B/C”“打 1–5 分”“是否继续循环”这类问题,然后再解析 JSON、校验 Schema、做重试和 fallback。只要 Agent 越来越长、工具越来越多、模型越来越分层,这些“小判断”的调用次数就会快速累积。
但 Decision Model 也很容易被过度营销。概率不是权限,typed output 不是正确性,低延迟也不等于低工作流总成本。 所以本文不做“谁替代 GPT/Claude”的产品新闻,而是回答更长期的问题:哪些判断应该交给规则,哪些应该交给传统 classifier,哪些适合 Decision Model,什么时候必须让生成式 LLM 或人工接管。
为什么 2026 年 10 月是一个明显拐点
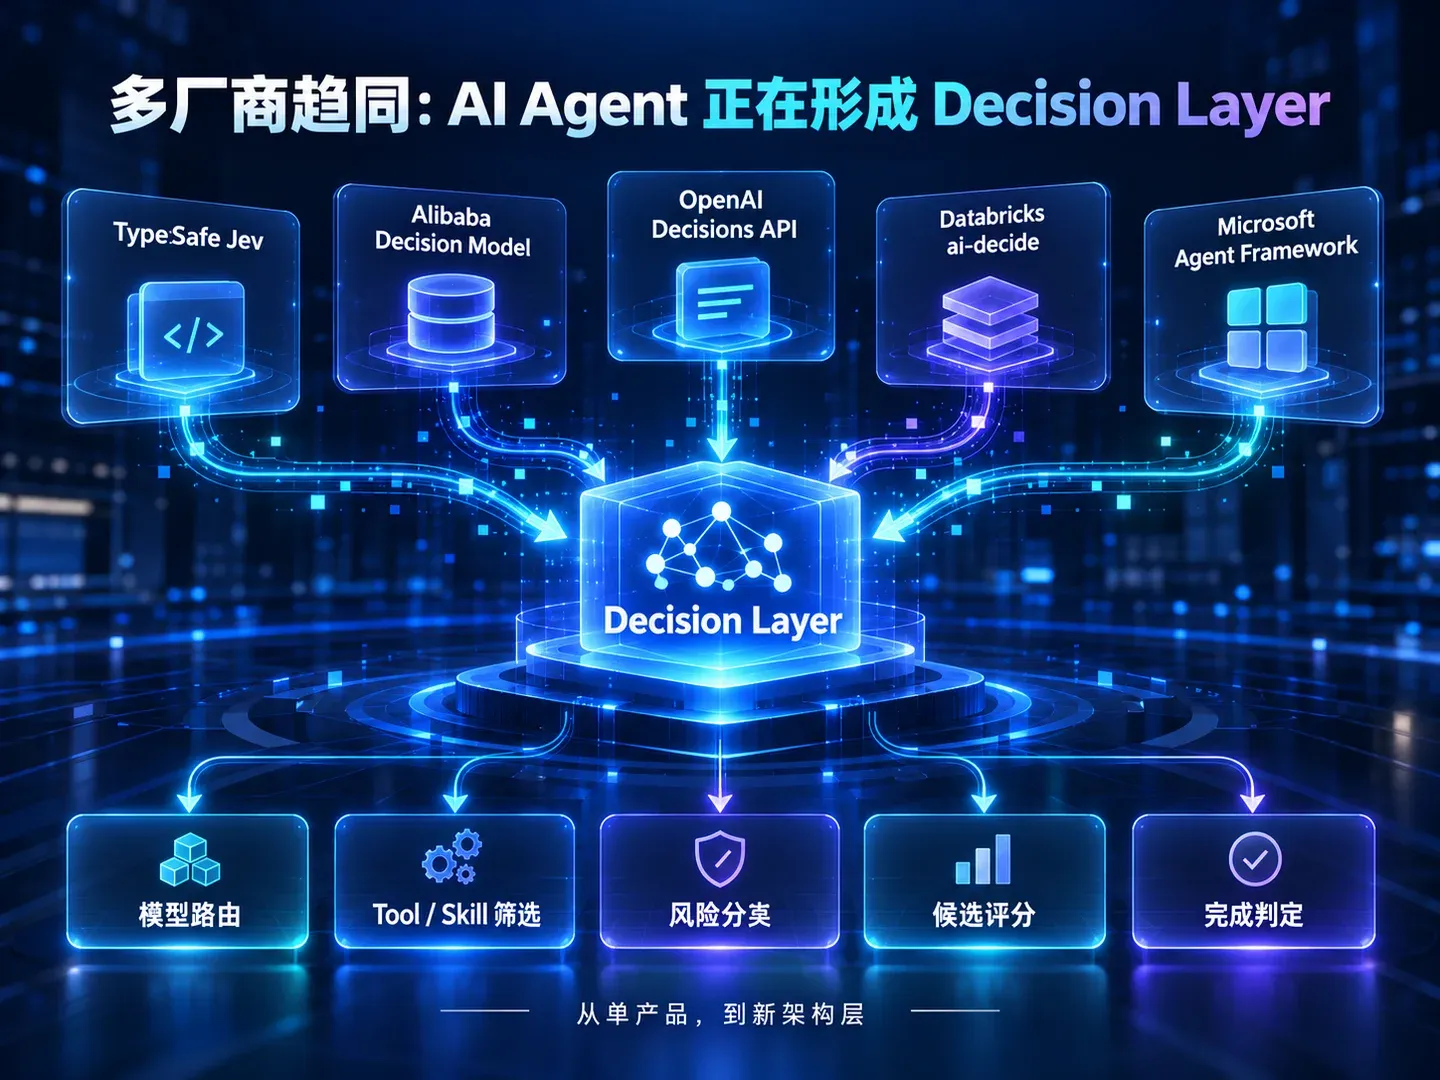
单看 Jev,很容易把它当成一家创业公司的特殊 API。现在已经不能这样看了。
**OpenAI 在 2026 年 10 月 6 日发布 Decisions API beta 与 gpt-6-luna。**官方 changelog 将其定位为把文本和图片转成 typed answers,并称在适用任务上可达到 Responses API 约 10 倍速度。API Reference 进一步明确了三种核心问题类型:predicate 用概率判断陈述是否成立,choice 从调用方给出的 typed options 中选择并返回概率分布与 confidence,score 在有序等级上评分;同一请求可以对共享 input 提出多个问题。它不是一个通用 Agent API,而是一个很窄的 bounded-decision 接口。
来源:OpenAI Changelog、Create a decision
**TypeSafe AI 则在 9 月 15 日发布 Jev,并把这类模型称为 System One Models。**Jev 的核心同样不是生成文章,而是输入 state + typed questions,返回有限决策及概率。它更早把“unstructured state in, typed probabilistic decisions out”当成独立产品类别。
来源:TypeSafe:Introducing System One Models & Jev
**Alibaba Cloud 在 9 月 28 日公开 Decision Model API。**它使用 decision-model-preview,支持 choice、noul、score,返回完整概率分布和 confidence,官方直接列出的场景包括 ticket routing、content moderation、agent routing 与 result verification。
来源:Alibaba Cloud Decision Model API
**Databricks 也提供 ai-decide beta。**这意味着“快速结构化判断”已经不只出现在 Agent 创业公司,而开始成为数据/AI 平台的独立 API 能力。
更值得注意的是框架层。Microsoft Agent Framework 的公开 Feature 讨论已经提出 provider-neutral 的 decision-oriented abstraction,明确把 loop evaluation、Tool selection、Skill selection 视为可能不需要完整 IChatClient 的 bounded decisions。这个讨论尚不等于官方已合并功能,但它说明框架设计者也开始把“Decision inference”和“Chat/Generation inference”拆成不同概念。
来源:Microsoft Agent Framework #8545
10 月 7 日的新变化是端侧 Decision Model。 Liquid AI 在 Hugging Face 发布开权重 d1-3B 和实验性 d1-omni-600M:前者支持文本与图像,后者支持文本与图像或文本与音频。官方报告的 d1-3B Decision Index v0.2.1 成绩为 48.57,另给出 Jetson 平台延迟;这些均为发布方测试结果,不是 XBSTACK 的 iPhone/Mac 实测。模型还需要验证 transformers>=5.14、trust_remote_code=True、端侧内存、量化/运行时兼容与实际任务准确率。在 Personal AI 里,它应与本地规则、传统分类器、云端 Decisions API 做同样标注集的消融对比,不应仅凭厂商 Benchmark 宣称速度/成本优势。
来源:Liquid AI / Hugging Face:Multimodal open d1 decision models for the edge
Decision Model 和 Structured Output 不是一回事
表面上看,Decision API 很像“让 LLM 输出 JSON”。工程上关键差异不在 JSON,而在任务目标。
传统 Structured Output 的路径通常是:模型仍然在做生成式推理,只是最后必须塞进 Schema。Decision Model / Decision API 的产品目标则更窄:调用方提前定义问题空间,模型直接返回有限选择、评分或概率。
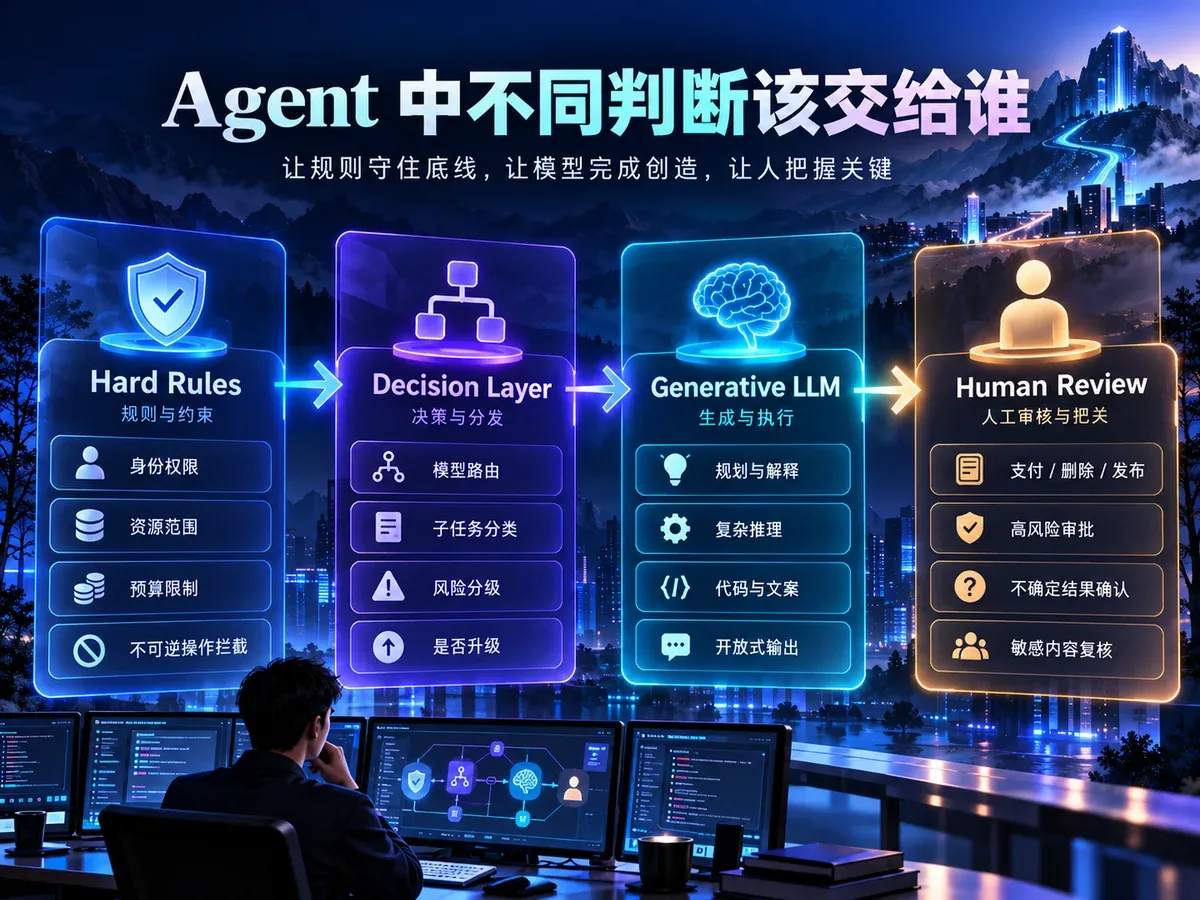
| 层 | 最适合解决什么 | 输出 | 典型失败 |
|---|---|---|---|
| Hard Rules | 权限、能力、法规、不可逆边界 | allow / deny / require approval | 规则遗漏、配置错误 |
| Traditional Classifier | 稳定标签、训练数据充足的分类 | label / probability | 分布漂移、标签覆盖不足 |
| Decision Model | 动态 criteria、路由、评分、有限选择 | choice / score / probability | 语义误判、校准失真 |
| Generative LLM | 复杂推理、规划、解释、生成 | text / tool args / structured object | 幻觉、成本、延迟、输出漂移 |
| Human Review | 高风险、模糊、不可逆决策 | 审批 / 否决 / 修正 | 人工成本、排队时延 |
这也是为什么“输出格式合法”不能当作正确性。一个模型可以永远返回 Schema 允许的枚举值,同时一直选错枚举。生产指标必须继续看 accuracy、calibration、false-safe / false-allow、fallback rate 和最终任务成功率。
Agent 里哪些步骤值得进入 Decision Layer
生产 Agent 里最适合拆出去的,往往不是“主推理”,而是主推理前后反复出现的小决策。
User intent
  ↓
Hard authorization / capability filters
  ↓
Decision Layer
  ├─ model routing
  ├─ tool shortlist
  ├─ skill / worker selection
  ├─ risk classification
  ├─ candidate scoring
  └─ loop completion
  ↓
Generative LLM / Planner
  ↓
Tool execution
  ↓
Terminal-state verification
  ↓
Fallback / Human review
模型路由是最直观的场景。先排除没有 vision、context 不足、工具不支持或价格超预算的模型,再在剩余候选中做语义型选择,比让一个 LLM 从所有模型里自由发挥更容易审计。
Tool / Skill shortlist也很适合。大型 Agent 平台可能拥有上百个工具和 Skill;Decision Layer 可以只负责从“已经授权”的候选中缩小范围,再把少量工具暴露给生成模型。顺序必须是 authorization → semantic selection,不能反过来。
Loop completion是另一个高频点。很多 Agent 每一轮都要判断“任务是否已经完成”“是否需要再调用一个工具”“结果是否应该升级 Reviewer”。这些问题往往只有有限答案,不一定值得再调用一次完整聊天模型。
结果验证和风险分级也适合变成一个独立信号,但它们不能替代真实 backend state 检查。XBSTACK 已经在 AI Agent Evaluation 和 Agent Side-Effect Evaluator 中把“模型说完成”和“系统真的完成”拆开;Decision Model 更适合作为一个评分/分流器,而不是最终真相来源。
哪些事情绝不能因为有 confidence 就交给 Decision Model
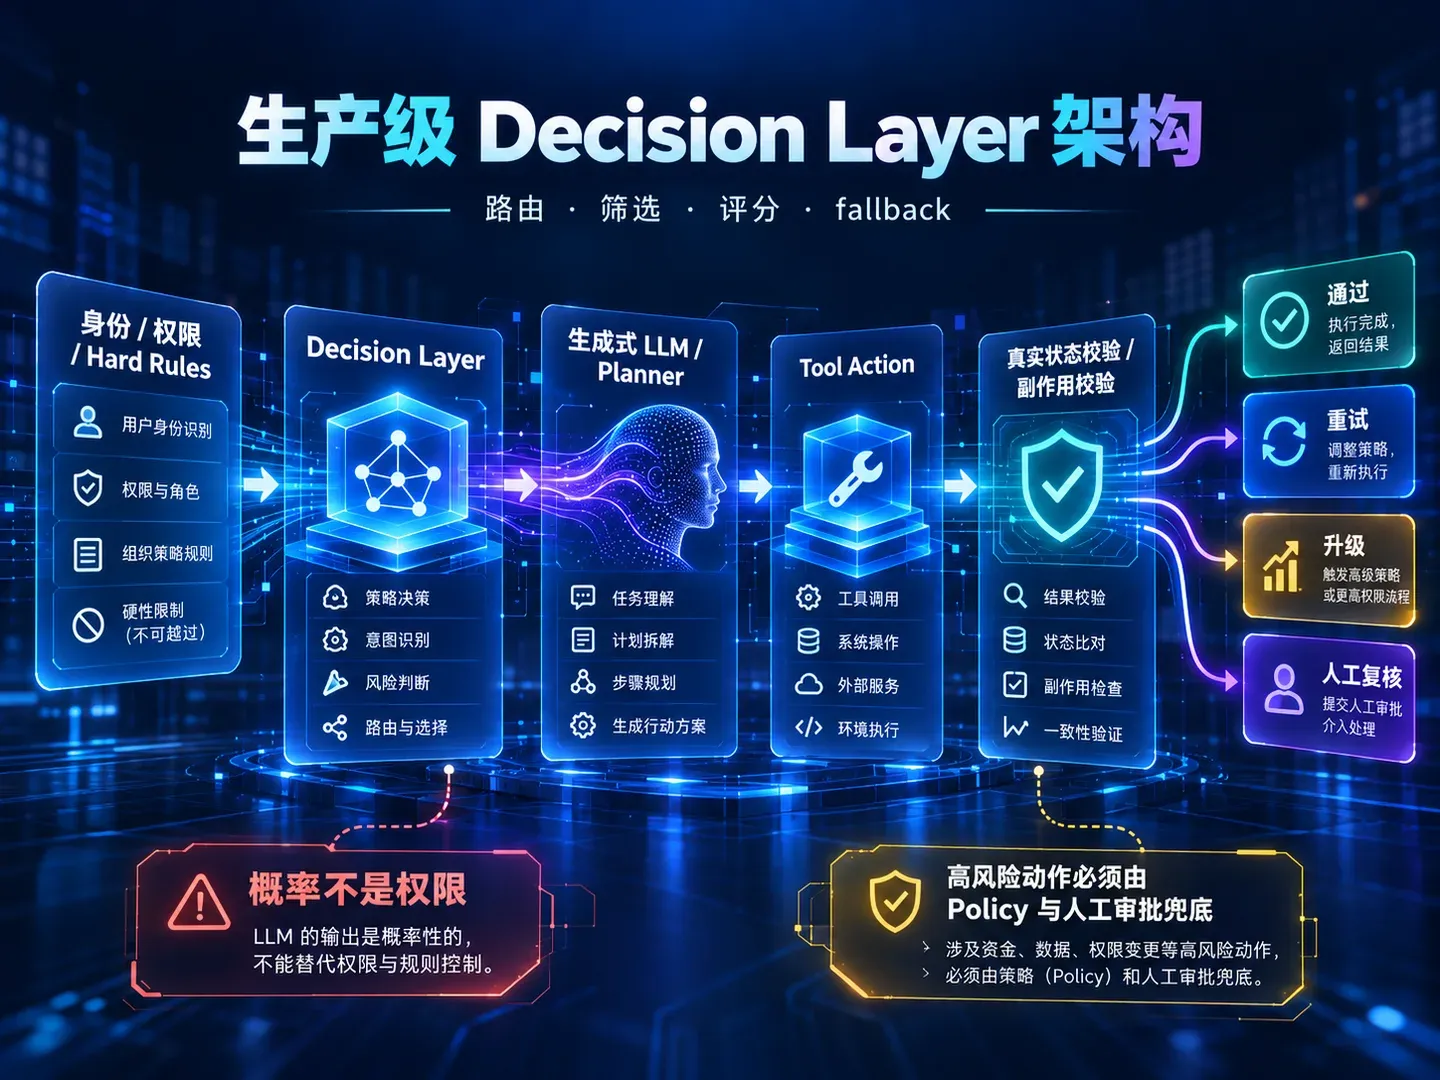
这里是整个架构最重要的边界:confidence 不是 permission。
下面这些事情仍然应该是 deterministic policy 或明确人工审批:
- 用户有没有资源权限;
- 租户能不能访问某个文件、数据库或 Tool;
- 是否允许转账、付款、删除、生产发布;
- 是否允许读取或外发密钥、身份凭据和隐私数据;
- 合规规则是否命中;
- Kill Switch、预算上限、速率上限;
- 不可逆动作是否必须二次确认。
Decision Model 可以说“这个调用看起来像 destructive”,但不能因此获得执行权。更安全的组合是:模型提供 semantic signal,Policy Engine 决定 authority。 这和 AI Agent Tool Authorization / Policy Gate 的原则完全一致。
四条技术路线怎么选:Rules、Classifier、Decision Model、LLM
如果把所有问题都交给 Decision API,只是把“所有问题都交给 LLM”换成了另一个单点依赖。更合理的选择方法是先看任务结构。
**固定且可枚举的硬边界 → Rules。**例如生产删除必须审批、某租户禁止外发文件、模型不支持图片。这些规则越确定,越不应该概率化。
**标签长期稳定且有训练数据 → 传统 Classifier。**如果业务只有 20 个长期不变的工单意图,而且已经积累大量标注,fine-tuned classifier 可能更便宜、更可控,甚至完全本地。
**Criteria 经常变化、输出空间有限 → Decision Model。**例如每次可选模型不同、Tool catalog 动态变化、Reviewer 阈值按任务调整、当前 Agent loop 只需要 stop/continue/escalate。
**需要复杂推理、规划、解释 → Generative LLM。**如果问题本身没有封闭的候选空间,或者要理解跨域上下文、生成代码、组织行动计划,Decision Model 就不该被强行扩展成万能模型。
**高风险 + 高不确定 → Human。**尤其是支付、法律承诺、生产删除、隐私外发等动作,系统应该把“升级人工”视为正常路径,而不是失败。
Jev 的现有第三方实验证明了什么,又没证明什么
原 Jev 页面里最有价值的一组材料仍然值得保留,因为它给了 Decision Model 一个真实 Agent 场景,而不是情感分类 Demo。
themsquared/jev-benchmark 用 60 条人工标注的 Agent Tool Call 做风险分类:34 条 clear、14 条 ambiguous、12 条 adversarial,类别是 readonly、destructive、privileged、exfiltration。同一任务定义下,仓库报告 jev-latest、jev-preview 和 Claude Sonnet 5 都是 55/60(91.7%);ambiguous slice 都只有 71.4%。该作者测得 Jev p50 延迟约 378–422 ms,Claude Sonnet 5 约 1371 ms,并报告每次调用估算成本差距明显。
这些是第三方作者在自己的数据集、网络和价格快照上的结果,不是 XBSTACK 实测。它最有价值的结论也不是“Jev 赢了”,而是:在一个窄、结构化、有限标签的任务里,frontier LLM 并没有展示额外 accuracy;真正困难的 ambiguous case,三个后端一起失败。这说明 taxonomy 与边界定义可能比换模型更重要。
另一个 routing experiment 更重要,因为它提供了反例。TokenTrim/jev-routing-experiment 在 RouterArena/LLMRouterBench 路由实验中加入 Jev difficulty signal,同时也跑了 no-Jev ablation。公开结果显示 retrieval evidence 已经保留了主要收益,去掉 Jev 后前沿几乎不变。
这意味着 **Decision Model 不能靠“加上去以后总分变高”证明价值,必须做消融实验。**至少要比较:
Rules only
Rules + retrieval
Rules + classifier
Rules + Decision Model
Rules + retrieval + Decision Model
Structured-output LLM router
来源:TokenTrim/jev-routing-experiment
dhruvmehra/jevbench 进一步把对手扩展到 Jev、开源 System One、轻量 LLM、frontier LLM、fine-tuned DistilBERT 和 BART-MNLI zero-shot NLI。这个比较框架比“Decision Model vs GPT”更接近真实工程决策:Decision Model 真正要证明的,是它在动态 criteria、概率校准、低延迟和低维护成本之间提供了传统方案没有的增量。
对 Personal AI 来说,Decision Layer 可能会更重要
Personal AI Agent 往往同时拥有长期 Memory、个人身份、跨 App Actions、Credential 和后台执行能力。它会频繁遇到这类判断:这条信息应该只留本地还是可以发云端?这个任务应该调用哪个 App?要不要向用户请求确认?应该用本地小模型、云端强模型,还是根本不需要模型?
所以 Decision Layer 很适合放在 Personal AI Agent 架构 的 Runtime/Policy 中间,但前提是数据边界先于模型能力。
敏感字段、身份权限、文件范围和 Credential 不应该为了让云端 Decision API 判断而原样上传。可发送的信息应先做最小化、脱敏和作用域限制;如果产品要求“数据不出设备”,则应优先测试本地 classifier、开源小模型和规则,而不是为了使用云端 Decision Model 改变隐私边界。
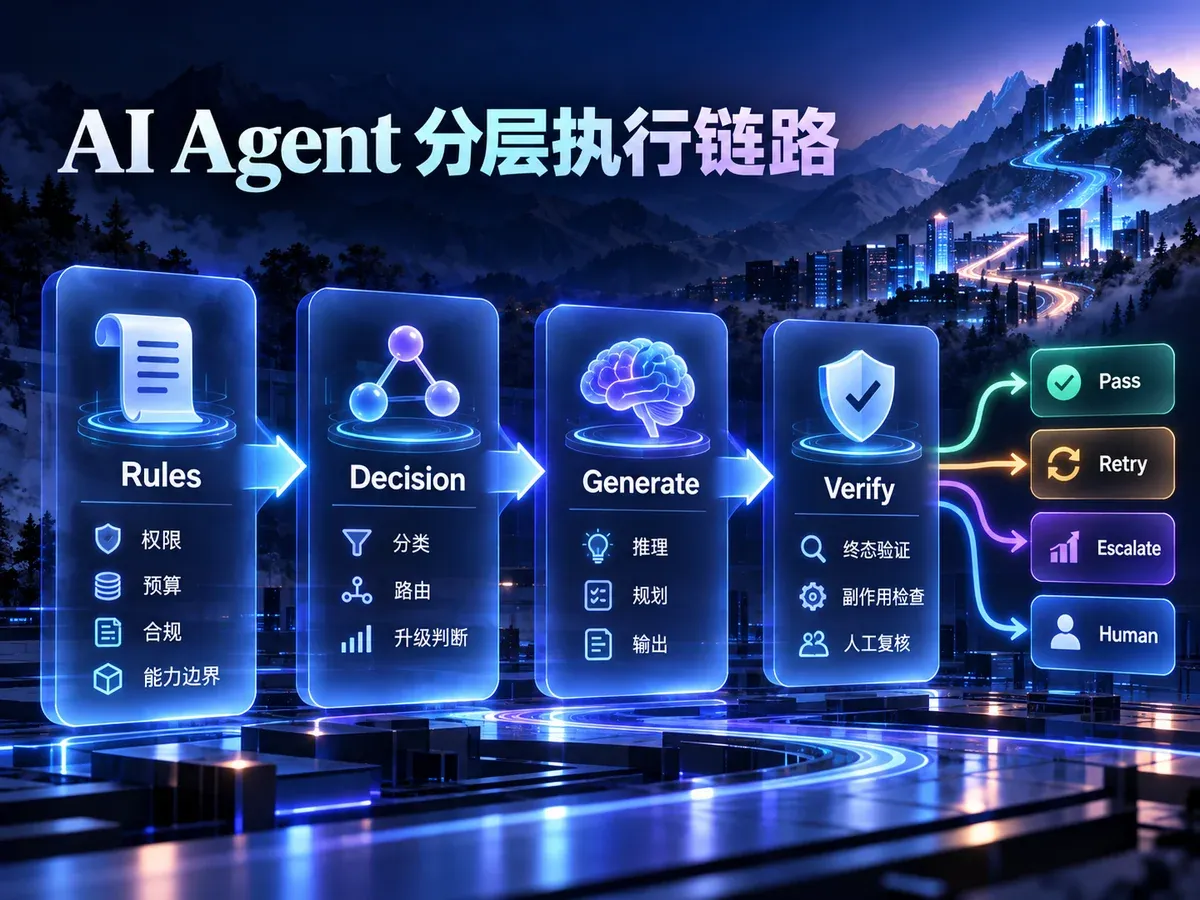
我建议的生产架构:Rules → Decision → Generate → Verify
一个更稳的 Agent Control Plane 可以拆成四层。
第一层,Hard Rules / Capability Filters。处理权限、合规、预算、模型能力、租户边界和不可逆动作。
第二层,Decision Layer。处理有限的语义判断:路由、筛选、评分、是否升级、是否继续。它可以由传统 classifier、OpenAI Decisions API、Jev、Alibaba Decision Model 或其他实现承担,接口最好保持 provider-neutral。
第三层,Generative Layer。真正需要推理、规划、Tool arguments、代码、解释或自然语言输出时再调用生成式模型。
第四层,Verification / Human Layer。对真实 backend state、副作用、支付/删除/发布等高风险结果做确定性验证或人工批准。
Identity / Policy / Capability
          ↓
     Decision Layer
          ↓
 Generative LLM / Planner
          ↓
      Tool Action
          ↓
Terminal State / Side Effect Check
          ↓
  Pass / Retry / Escalate / Human
这套结构的价值不在于多加一个模型,而在于让不同类型的判断有不同的责任边界。
XBSTACK 下一步应该怎么测,而不是继续写产品新闻
现在还不能写“OpenAI Decisions API 比 Jev 更好”或“Decision Model 比 LLM 快多少”。要得到有用答案,下一步应该做一个 provider-neutral benchmark。
第一组测试是模型路由:从真实开发/运维/内容任务中建立标签,比较 Rules、传统 classifier、Decision Model、structured-output LLM,以及带 retrieval 的组合。最终指标不是 label agreement,而是 routing regret、任务成功率和 cost per verified task。
第二组测试是Tool/Skill shortlist:从已经授权的候选集合中选出最相关子集,测 recall、上下文缩减、最终 Tool selection 成功率和错误遗漏。
第三组测试是confidence fallback:刻意加入模糊输入、缺失字段、对抗表达和边界样本,测 calibration、false-safe rate、fallback rate、人工复核率。
第四组测试是端到端成本:把 Decision 调用、LLM 调用、Tool、重试、fallback、人工复核和误路由返工全部算进去。只有这样才能判断“便宜的小决策”有没有真的降低整个 Agent 的成本。
2026 年 10 月 12 日:Claude Haiku 5.5 的 Agent 路由与 100K Token 计费边界
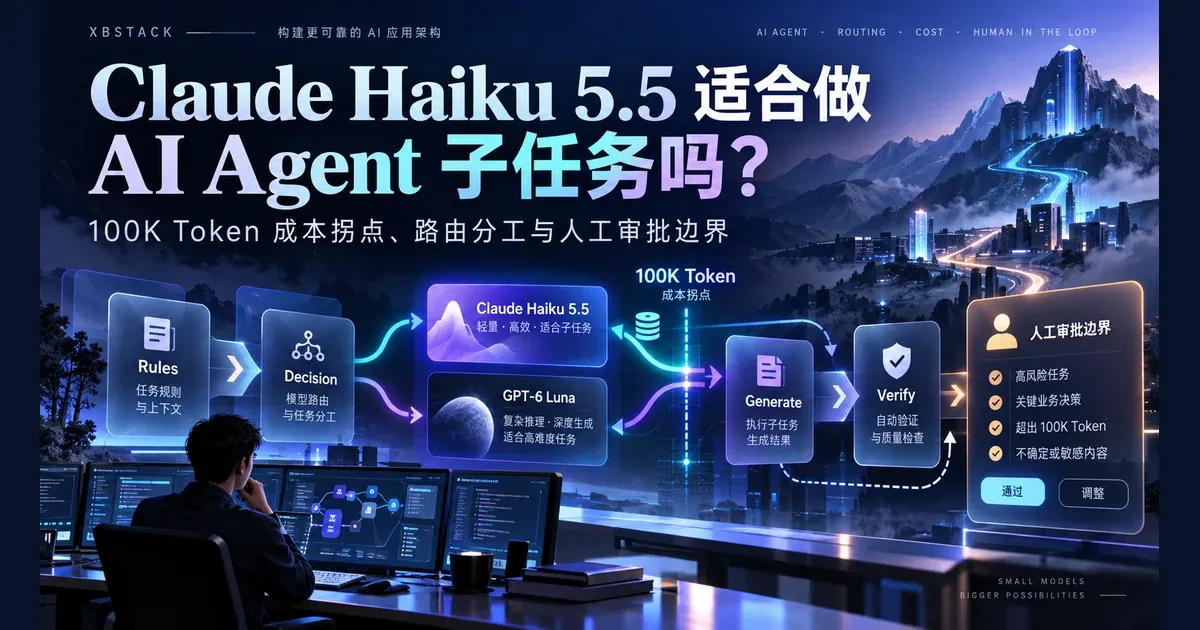
图中的 100K Token 标记仅表示价格档位与上下文预算,不意味着请求超过该值就必然需要人工审批;真正的审批依据仍是操作权限、敏感性和不可逆风险。
官方资料与假设成本分析(非 XBSTACK 实测): Anthropic 10 月 7 日发布的 claude-haiku-5-5 明确面向高频分类、路由和子 Agent;其标准文本费率在输入不超过 100K Token 时为每百万输入 USD 0.10、输出 USD 0.50;请求输入超过 100K 后分别为 USD 0.50 与 USD 2.50。OpenAI gpt-6-luna 常规费率在适用输入范围内为 USD 0.10 / USD 0.50。因此相同的单价不等于相同的单任务成本:不同 tokenizer、思考 Token、长上下文和重试都会改变真实账单。以人为指定的相同 Token 数量作纯费率计算,20K 输入+1K 输出两者均约 USD 0.0025;120K 输入+3K 输出在上述档位下分别约 USD 0.0675 与 USD 0.0135。它们是假设场景的理论费用,不是 API 实际调用费用,更不是准确率或速度结论。
XBSTACK 已整理一个 14 条人工编写的分类、运维诊断、危险操作与人工审批用例集,设计 Haiku Messages 与 Luna Responses 的统一标签评估;当前执行环境没有两方 API 凭据,只完成测试数据校验和费率计算,没有运行双模型推理。此外,OpenAI Decisions API 是专门输出 choice/predicate/score 的不同接口;若与生成式模型比较,应单独记录请求类型,不应混淆为同一推理任务。对于删除、支付、生产发布等操作,即使小模型给出高置信度,也不能代替硬规则与人工授权。
在完成这些一手数据之前,XBSTACK 对这条趋势的判断保持克制:Decision Layer 值得成为 Agent 架构的一等概念,但不应该成为新的万能模型层。
最终判断
Jev 在 9 月中旬出现时,看起来还像一个值得观察的新模型类别。到 10 月 7 日,OpenAI、Alibaba、Databricks 与 Microsoft Agent Framework 的相关动作已经让问题发生变化:开发者不再只需要问“Jev 值不值得用”,而应该问:
Agent 里哪些步骤根本不需要开放式生成?这些 bounded decisions 是否应该变成独立、可校准、可替换的 Decision Layer?
我的结论是:**应该。**但最合理的位置是 Hard Rules 之后、Generative LLM 之前;高风险动作最终仍由 Policy、真实状态验证和 Human Review 兜底。
这比“换一个更快的模型”更可能成为未来 6–24 个月持续存在的 Agent 架构问题。
FAQ
AI Agent 决策模型是什么?
它是一类面向有限判断空间的模型或推理 API。调用方给出 input/state 和有限问题空间,系统返回真假概率、候选选择、等级评分或置信度,更适合 routing、scoring、shortlisting、completion check 等任务。
OpenAI Decisions API 和 Responses API 有什么区别?
OpenAI Decisions API 当前是 beta,专门做 bounded decision,支持 predicate、choice、score;Responses API 是更通用的生成/推理接口。官方称 Decisions API 在适用任务上可达到 Responses API 约 10 倍速度,但这个数字是 OpenAI 官方产品说明,不是 XBSTACK 独立 benchmark。
Decision Model 可以替代传统 classifier 吗?
不一定。固定标签且有大量训练数据时,fine-tuned classifier 可能更适合;criteria 经常变化、候选集合动态变化时,Decision Model 更有吸引力。必须用自己的任务做对照。
Decision Model 可以直接控制 Tool 权限吗?
不应该。它可以做风险分类或相关性判断,但 identity、resource scope、payment、delete、publish 等权限仍应由 deterministic Policy Engine 和必要的人工审批控制。
XBSTACK 已经实测 OpenAI Decisions API 和 Jev 了吗?
还没有完成统一的一手 A/B。本页区分官方能力、第三方可复核 benchmark 和 XBSTACK 自己尚未执行的测试计划;在统一 Harness 完成前,不会声称某个 Decision Model 默认更快、更准或更便宜。
参考资料
- OpenAI API Changelog:Decisions API beta
- OpenAI API Reference:Create a decision
- Anthropic:Claude Haiku 5.5 发行说明与计费
- Claude Platform:Haiku 5.5 模型规格
- OpenAI:GPT-6 Luna 模型规格与价格
- TypeSafe AI:Introducing System One Models & Jev
- Alibaba Cloud:Decision Model API
- Databricks:ai-decide API
- Microsoft Agent Framework:Decision-oriented inference proposal
- Independent:Agent Tool-Call Risk Benchmark
- Independent:Jev Routing Experiment
- Independent:Jev vs LLM / BERT / NLI
继续阅读
- Personal AI Agent 架构:Memory、权限、跨 App 与本地/云端 Runtime
- AI Agent 工具授权与 Policy Gate
- AI Agent Evaluation:从轨迹到真实终态与副作用
- AI Agent 生产化治理:模型路由、权限、成本与回滚
从单个 Agent 问题继续进入完整生产体系
AI Agent 专题统一组织架构、记忆、工具调用、评测、安全、部署和多智能体协作,让每篇文章都回到明确的主题主页面。
下一步:把执行边界补完整
完整专题路径 →继续处理下一层权限、工具、凭据或生产控制,不让问题停在“模型回答正确”这一层。
参与讨论
问题、验证与勘误
登录后可发表评论。所有新评论先进入审核;审核期间仅评论者本人和管理员可见,通过后才公开。